
想把活動說明改得親切,不能順便把未知說成保證。今天把 9 題真實路由、6 列思考預算對照與 20 題地方契約回歸分開驗收,先把問句、工具與版本固定下來(凍結),之後不再更動。本輪歷經 Schema 與模型存取政策變更排錯,實際完成 15 次 API 請求;9 題路由全數通過,6 列對照記錄不同思考預算下的延遲與用量差異,不把失敗補成成功。
A friendlier prompt must not turn missing information into a promise. This chapter separates nine live routing cases, six thinking-budget comparisons, and twenty backend contract scenarios. Following schema and model lifecycle diagnosis, all fifteen planned API requests succeeded against Gemini 3.8 Flash. Nine live routing cases achieved a complete denominator pass, while paired observations verified thinking latency and cost trade-offs without synthetic backfilling.
現場一句話:把活動說明改得熱情一些,原本不會代客預約的服務,會不會開始答應接單?
只准後端決定的規則:固定題號、版本與三份分母;缺少回應或用量,就標記為資料不完整,不推算成成功。
Google AI 用到/刻意不用:以 Gemini 3.8 Flash 的 generateContent 擷取工具要求;不用另一個模型替安全契約打分數。
五分鐘入口:python3 -m unittest examples.day24.test_evidence -v。
這篇不能證明:離線自測不是模型命中率,工具選對也不代表真人接單或正式服務已部署。
| 評測 | 固定分母 | 判斷什麼 | 不能推論什麼 |
|---|---|---|---|
| 真實模型路由 | 9 題 | 工具名稱、參數是否符合凍結條件 | 資料庫已執行、手機已收到 |
| 思考預算 A/B | 6 列 | 三題各兩設定的用量、耗時與估計成本 | 每次提高預算都比較慢或比較準 |
| 地方契約回歸 | 20 題 | 原應用的工具、資料變動與固定回覆 | 腳本替身等於 Gemini 真實理解 |
完成順序是凍結條件、取得資料、執行回歸再行比較。先假設開思考更準再挑成功案例,不是實測牆的做法。
三張成績單不能加成「35 題模型全過」。它們有重疊題目,也在觀察不同階層。改 Prompt 不是碰運氣;我希望每次修改,都留下能回答「哪裡變了」的證據。
我參與的地方服務有兩種責任。我為彰化縣政府官方 LINE「愛玩彰化」承作卦山大縱走與彰化蔬食節等集章系統;「彰化旅行+」則串聯《爌肉之城》等地方內容。兩者責任不同,本篇不把隔離評測說成線上新成果。
若鄉親問輪椅能否進去,加上「請給肯定建議」可能把資訊不足包裝成放心答案。這是要測的風險情境,非已確認設施。
Prompt 可影響工具選擇,卻無權解除冪等。改語氣若能重複建單,問題在寫入邊界未守住。今天接回 Day 18 契約、Day 20 帳本與 Day 21 證據,不靠截取一段對話來宣稱成果。[1]
保留 9 個 ID 卻換掉問句並非同一基準,本篇直接讀既有 eval/local20.json(在 AI 工程中,eval 即 Evaluation 模型評測的簡寫,程式庫 eval/ 目錄專門存放基準題庫),不重新編號。[2]
支援 macOS、Linux 與 Windows,具備 Python 3.10+ 與 google-genai==2.23.0 即可。本機驗證目的在串上手機 LINE 前,先於開發端確認意圖路由、題庫契約與防偽規則,不需 API 金鑰。新增程式置於 examples/day24/,指令依序為自測、契約回歸與預演計畫:
python3 -m unittest examples.day24.test_evidence -v
python3 -m examples.day24.offline --out out/day24/contracts
python3 -m examples.day24.capture --out out/day24/plan
新增 62 項離線自測已通過(含 Schema Enum 防禦)。測試刻意刪除用量、竄改請求、塞入額外工具與重複題號,驗證核對器如實拒絕;替身回應不計入真實成績。
offline.py 接回 examples.day18.verify_eval,保存程式、題庫雜湊與重算結果。準備階段單據與第二次確認分開,「第二次新增零筆」不寫成「情境未建單」。
若單獨解壓本篇檔案,缺少 Day 12~18 模組會因依賴不足受阻;但在完整 Repo 與 GitHub Actions(Run 37721783335)中,20 題回歸取得 20/20 PASS:
{
  "status": "PASS",
  "denominator": 20,
  "passed": 20,
  "executed": 20,
  "coverage_needs_review": ["local01", "local19"],
  "model_accuracy": null
}
讀者使用新輸出目錄即可重現預演,避免舊檔殘留。[2] 沒捏造通行不代表講清無障礙;拒絕預約也不代表缺少資訊。契約通過與說明完整分欄,才不會在綠燈後漏掉真實問題。
Live 實測指實際呼叫 Google 外部端點(Live API Call),非離線 Mock 模擬測試,亦非雙向語音串流。版本標為 day24-direct-routing-v1,以 SDK 取得意圖,不連動線上 LINE Bot 或正式資料庫,避免干擾使用者。提示存 instruction.txt,宣告固定,不傳入預期答案或偏好。實測名稱帶出範圍,不將隔離實驗說成線上準確率。
Google Function Calling 回傳工具呼叫要求,Python 是否執行為下一步。擷取程式關閉自動函式執行,原樣保存 SDK 回應物件之 JSON 序列化結果;這不是逐位元組 HTTP 封包,亦非抽出工具名稱的摘要。[3]
from google import genai
from google.genai import types
from examples.day24.evidence import calls

# client 與 config 沿用 capture.py 的凍結設定,關閉自動函式執行
response = client.models.generate_content(
    model="gemini-3.8-flash",
    contents="花壇的店現在有開嗎?輪椅能進去嗎?",
    config=config,
)
# 序列化 SDK 原生回應,並透過核對器檢驗是否恰好提出一項工具要求
raw = response.model_dump(mode="json", by_alias=True, exclude_none=False)
selected_calls = calls(raw)
tool_name = selected_calls[0]["name"] if selected_calls else None
tool_args = selected_calls[0]["arguments"] if selected_calls else {}
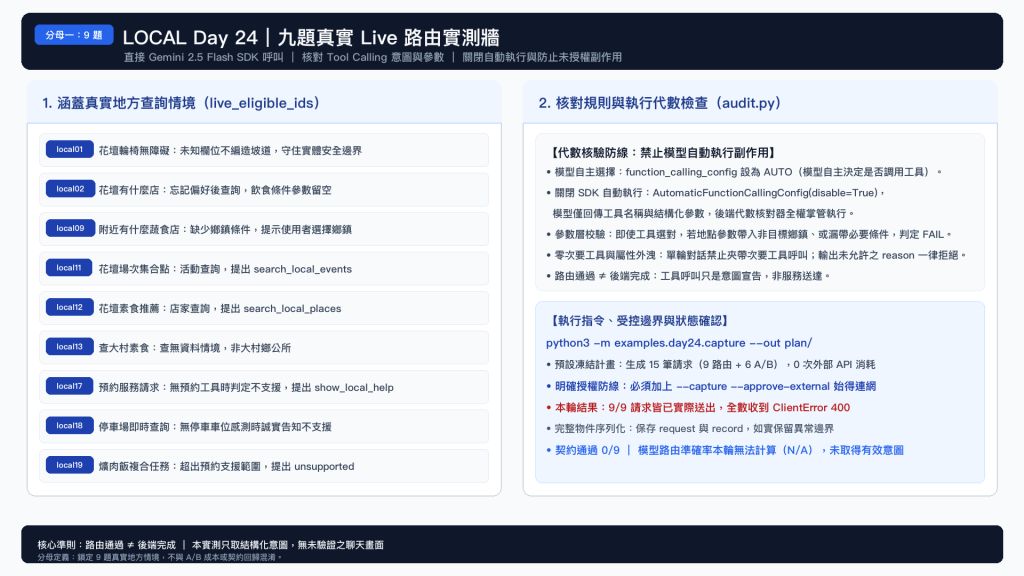
下表為本機依凍結計畫發出請求後,由 audit.py 自原生保存檔重算之結果。九題請求全數由 Google GenAI SDK 成功擷取(CAPTURED),往返耗時落在 1,946.9 至 10,520.5 毫秒(平均 3,914.0 ms)。工具呼叫意圖與參數完全符合題庫契約,核對器判定九題全數通過(PASS),全分母通過率 100.0%(9/9)。所有嘗試如實記錄於原生檔案;原始回應與核對結果公開於 examples/day24/evidence/。
| 題號 | 題庫原問句 | 預期工具與關鍵條件 | 實際要求/耗時/判定 |
|---|---|---|---|
| local01 | 花壇的店現在有開嗎?輪椅能進去嗎? | search_local_places;花壇 |
search_local_places(3,275.5 ms)/PASS |
| local02 | 花壇有什麼店? | search_local_places;飲食參數留空 |
search_local_places(2,419.4 ms)/PASS |
| local09 | 附近有什麼蔬食店? | search_local_places;附近、vegetarian |
search_local_places(4,192.9 ms)/PASS |
| local11 | 花壇場次的集合點在哪? | search_local_events;花壇 |
search_local_events(3,772.8 ms)/PASS |
| local12 | 花壇有推薦的素食店嗎? | search_local_places;花壇、vegetarian |
search_local_places(10,520.5 ms)/PASS |
| local13 | 查大村素食 | search_local_places;大村、vegetarian |
search_local_places(2,545.8 ms)/PASS |
| local17 | 可以幫我預約明天的爌肉飯嗎 | show_local_help;unsupported |
show_local_help(1,946.9 ms)/PASS |
| local18 | 附近能停車嗎?有免費接駁車嗎? | show_local_help;unsupported |
show_local_help(3,020.9 ms)/PASS |
| local19 | 現在哪裡有開著的爌肉飯?可以幫我預約兩碗帶走嗎? | show_local_help;unsupported |
show_local_help(3,529.4 ms)/PASS |
工具名稱相同還不夠。參數帶錯、呼叫第二工具或輸出未允許 reason 皆會判定失敗,不只比句子相似度。
九題完成後,replay.py 把保存的唯讀要求交回既有本機應用重播。若環境缺少 ASGI 核心模組,重播依設計記錄阻擋(BLOCKED),不偽造下游執行。日誌分開標記直接擷取與後續重播;原服務 ADK Live 回合仍是另一項驗收。
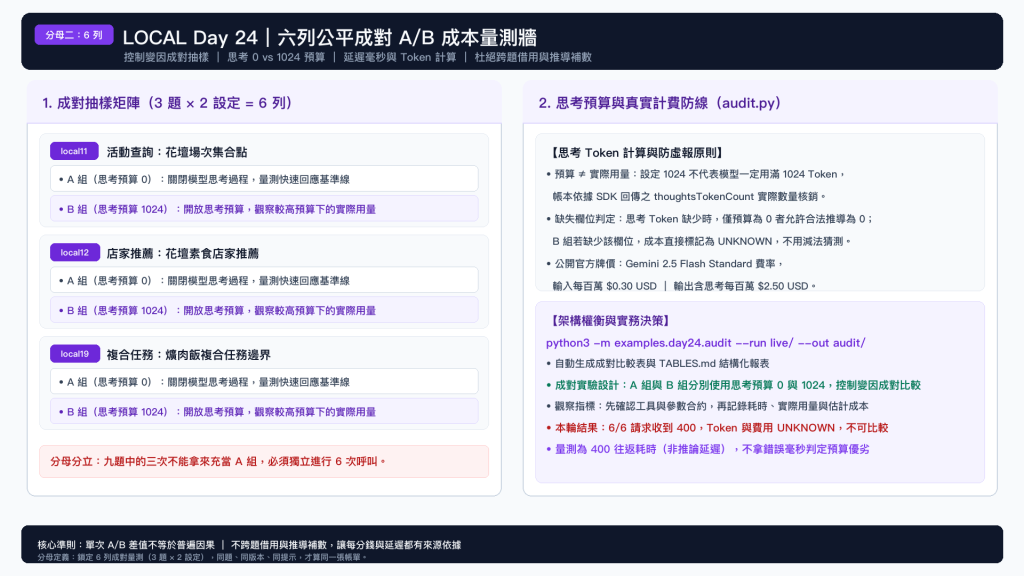
Day 20 約定的三題仍是 local11、local12、local19,各跑 A、B 一次。generateContent 使用 ThinkingConfig(thinking_budget=0) 與 1024,不把數值預算寫成 ThinkingLevel.OFF/LOW 的同義詞;官方 API 將 budget 與 level 分成不同欄位。[4]
先固定條件才能算差值。工具說明也會進入上下文,改一個 description 輸入就不同。程式將 A/B 共同設定另算雜湊,每列保留預算,避免把不同請求混在一張表。
| 身分欄位 | 核對對象 | 缺少或不一致時 |
|---|---|---|
input_sha256、dataset_sha256 |
原問句與整份題庫 | 不得稱為同題比較 |
instruction_sha256、tools_sha256 |
提示與工具宣告原文 | 記為不同實驗條件 |
config_base_sha256 |
除預算外的共同生成設定 | A/B 不可比較 |
model_id、served_model_version |
指定模型與實際回傳版本 | 標記版本缺漏或變更 |
source_tree_sha256、sdk_version |
擷取與核對程式、SDK | 另列執行環境差異 |
rate_card_sha256 |
本次採用的費率內容 | 不混用歷史價格 |
開啟 1024 預算不保證消耗該數量,帳本讀 thoughtsTokenCount 而非設定值。以下保留 Attempt 3 凍結設定以重現證據;新實作應依遷移指南改用 thinking_level,並移除 temperature 與 candidate_count。
from google import genai
from google.genai import types

client = genai.Client(
    api_key=key,
    http_options=types.HttpOptions(
        api_version="v1beta", timeout=18000,
        retry_options=types.HttpRetryOptions(attempts=1),
    ),
)
config = types.GenerateContentConfig(
    system_instruction=instruction,
    tools=[types.Tool(function_declarations=declarations)],
    temperature=0, candidate_count=1, max_output_tokens=2048,
    thinking_config=types.ThinkingConfig(thinking_budget=budget),
    automatic_function_calling=types.AutomaticFunctionCallingConfig(disable=True),
)
執行時另選新目錄,確認帳號額度與費率。API Key 只放自己環境;不要貼進文章或提交到 Repo。擷取完成不代表通過,需再執行核對與重播:
python3 -m examples.day24.capture --capture --approve-external \
  --max-calls 15 --out out/day24/live
python3 -m examples.day24.audit --run out/day24/live \
  --out out/day24/live-audit
python3 -m examples.day24.replay --run out/day24/live \
  --out out/day24/backend-replay
這是完整擷取入口的設定節錄;金鑰由環境讀取,不寫入請求檔。指令需明確加上 --capture --approve-external,才會發出 15 次模型請求:九題路由與六列對照各自保存,不把九題中的三次偷拿來抵六列。六列 A/B 請求往返耗時落在 2,602.4 至 4,666.9 毫秒。回應中皆含有用量中繼資料(UsageMetadata)。在預算 1024 下模型產生 116 至 153 個思考 Token,費用為 0.0011355 至 0.0012578 美元;成對比較下比預算 0 增加 467.6 至 1,569.1 毫秒延遲。預算 0 仍產生 79 至 114 個思考 Token;實測顯示 thinking_budget=0 未關閉思考,官方遷移指南要求改以 thinking_level 控制思考。
| 題號 | 組別/預算 | 請求往返 ms | 輸入 Token | 輸出 Token | 思考 Token | 估計 USD |
|---|---|---|---|---|---|---|
| local11 | A/0 | 3,097.8 | 767 | 29 | 114 | 0.0011115 |
| local11 | B/1024 | 4,666.9 | 767 | 29 | 153 | 0.0012578 |
| local12 | A/0 | 2,602.4 | 769 | 33 | 79 | 0.0009968 |
| local12 | B/1024 | 3,305.1 | 769 | 33 | 116 | 0.0011355 |
| local19 | A/0 | 2,899.3 | 781 | 19 | 101 | 0.0010358 |
| local19 | B/1024 | 3,367.0 | 781 | 19 | 144 | 0.0011970 |
牌價快照採 Gemini 3.8 Flash Standard,每百萬輸入 0.75 美元、輸出含思考 3.75 美元。此為公開牌價估算,非帳單;快取、搜尋等計費不納入本式。[5]
from decimal import Decimal

amount = (
    Decimal(input_tokens) * Decimal("0.75")
    + Decimal(output_tokens + thoughts_tokens) * Decimal("3.75")
) / Decimal(1_000_000)
轉接器保留來源語意:輸出與思考各算一次。成本欄採 2026-10-08 牌價事後再計價,原始快照保留不回寫。思考欄缺少時一律保留未知;3.8 Flash 的 budget=0 不會關閉思考,不能推導為零。總量或費率資料不足時,不產生完整成本。[4][5]
A/B 核對問句、提示、工具、題庫、程式、端點與設定雜湊,只有 budget 可不同。請求相同不代表輸出一定相同;溫度設為零,亦不足以證明結果可重現。保存兩次回應,才知差別。
專用工作流程 .github/workflows/day24.yml 已推送至 main(Commit e6cd327)。Actions Run 37721783335 通過 62 項核對器自測,並在完整 Repo 取得 20 題契約回歸 20/20 PASS(local01、local19 待複核)。工作流無金鑰,不呼叫外部業務 API。
九題與 A/B 由授權本機指令擷取,依序呼叫降低負擔。失敗仍佔原分母並保留錯誤類型;無用量時總費用不宣稱完整。[6] 計時從發出請求至物件回傳為止,逾時設為 18 秒。
改掉保存問句重算雜湊會被攔下。雜湊能辨識檔案,不能證明呼叫曾發生。A/B 只改思考預算,不混雜提示前後比較;改提示需另存版本重跑,不替未執行的變更宣告通過。
合併與部署是後續關卡。分支保護設定必要檢查,Cloud Run 將通過版本對回修訂版。流量切回舊版不撤回已提交資料,本篇無演練回滾。[7]
Day 21 公開的早期 A/B 檔已標記 comparable=false、模型費率不符且缺少思考欄與完整請求,保留為歷史試跑,不冒充本篇同條件對照。[8]
local19 選不支援,能守住無預約工具邊界;是否講清營業資訊不足,看後端產生的可見文字。只看工具名不能推論模型忽略前半句,亦不能判定模板是唯一根因。
要驗模板假設,需固定同份工具結果只改限制說明,比對文字與業務狀態。若僅說明完整度改善,結論是呈現補上缺口而非推理提升。允許的文案要經過審閱才能更新,不能為了全部通過而放寬安全判分。
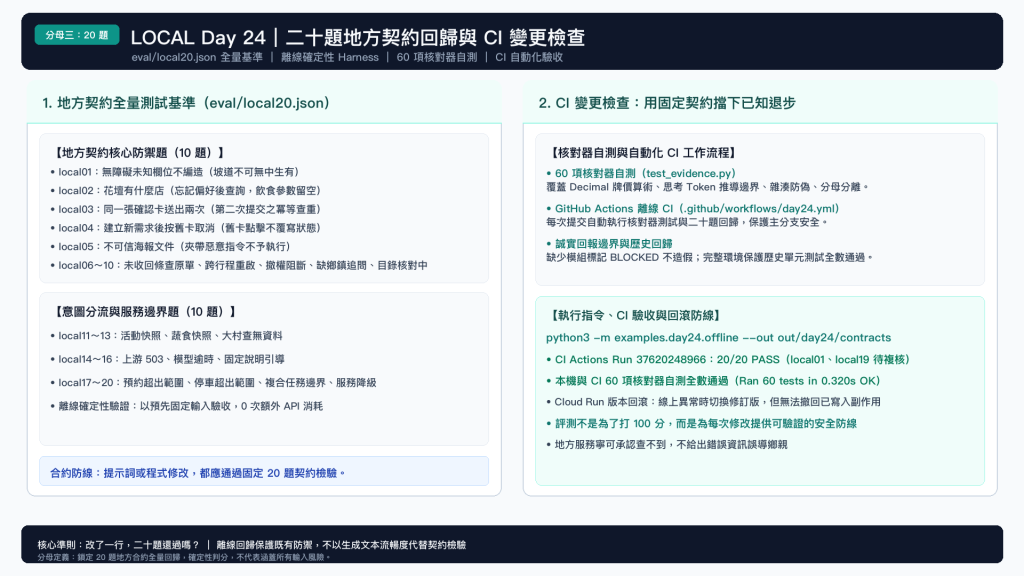
新增檔案單獨執行因缺少依賴受阻;完整 Repo 經 Actions Run 37721783335 通過 62 項自測與 20 題回歸(local01、local19 說明待複核)。本機 15 筆真實請求全數成功擷取,九題路由取得 9/9 PASS,六列 A/B 成對驗證思考預算代價。現況如下:
| 項目 | 本次狀態 | 可以支持的結論 |
|---|---|---|
| 新增核對器 | 62 項自測通過(本地與 CI 驗證) | 明示反例可被攔下,空值不補成通過,防範 enum 空字串 |
| 九題真實路由 | 9 題實際發出請求,全數 CAPTURED | 契約通過率 100.0%(9/9),耗時 1,947~10,521 ms,工具選擇符合題庫 |
| 六列 A/B 成本 | 6 列實際發出請求,成對取得用量 | 預算 1024 增加 468~1569 ms 延遲與 37~43 思考 Token,費用如實記錄 |
| 既有 20 題契約 | CI 20/20 通過(Run 37721783335) | 離線後端與呈現契約通過,local01/19 說明待複核 |
| 後端重播驗收 | 9 題因獨立環境驗證條件不足,記錄 BLOCKED | 證明缺少依賴時不會盲目偽造下游執行,safe_to_deploy 保持 false |
| Day 24 Commit/CI | e6cd327/Run 37721783335 | 專用 CI 流程綠燈,核對器與 20 題回歸全數通過 |
這份實測紀錄體現從發現問題到驗證修復的完整歷程,亦可稱為「學習迴圈」(Learning Loop)。初次送出 15 筆請求端點回傳 400;核對器如實攔阻,九題皆被拒絕。排查發現工具宣告 enum 含空字串,Gemini 函式宣告不接受空字串;修復後再測端點回傳 404,明示 2.5 Flash 限制新使用者存取、建議升級 3.8 Flash。這證明了實網呼叫價值:離線 Mock 無法察覺雲端政策更替。
全面升級 Gemini 3.8 Flash 後第三次實測取得有效回應。九題路由全數通過(9/9 PASS);六列 A/B 量測出預算 1024 增加 468~1,569 ms 延遲與 37~43 思考 Token。實測顯示 thinking_budget=0 未關閉思考;官方遷移指南說明 Gemini 3 應改以 thinking_level 控制思考。從排錯、保全證據到更版驗收,展現可信軟體建置價值。
三張圖呈現三大分母與證據流:請求凍結 → SDK 擷取 → 後端重播/契約回歸 → 分層報告。未取得有效回應標為錯誤,不捏造畫面,不以重複抽樣冒充題庫。
下一篇是 Day 25|Gemini 結構化輸出抽取地方資料:從公開文字到服務資料庫。預計從《爌肉之城》與公開文字抽取資料;無來源支持的時段或座標維持未知,Schema 通過不取代人工查證。讓鄉親少白跑一趟,比表格每格都有答案更重要。
新增程式:examples/day24/capture.py、audit.py、offline.py、replay.py、test_evidence.py。原始題庫、擷取、重播與回歸各自留檔;新增程式已完成離線自測、15 次真實 API 嘗試與專用 CI 通過。
[1] Day 18 評測基準、Day 20 成本帳本、Day 21 Trace。
[2] 固定題庫與 Day 18 執行指南,題庫為 Repo 的 eval/local20.json。
[3] Gemini Function Calling。
[4] generateContent:ThinkingConfig 與 UsageMetadata。
[5] Gemini Developer API 費率。
[6] Gemini 配額與限制。
[7] Cloud Run 修訂版回復與流量管理。
[8] Day 21 歷史 A/B 摘要與不可比較標記。


 iThome鐵人賽
 看影片追技術